Meta adia os termos que lhe davam acesso aos sites das empresas: o que muda e o que fazer
A Meta adiou os termos que a deixavam recolher conteúdo dos sites das empresas e admite novo adiamento. O que muda e o que fazer no seu site.
Neste artigo · 7 secções
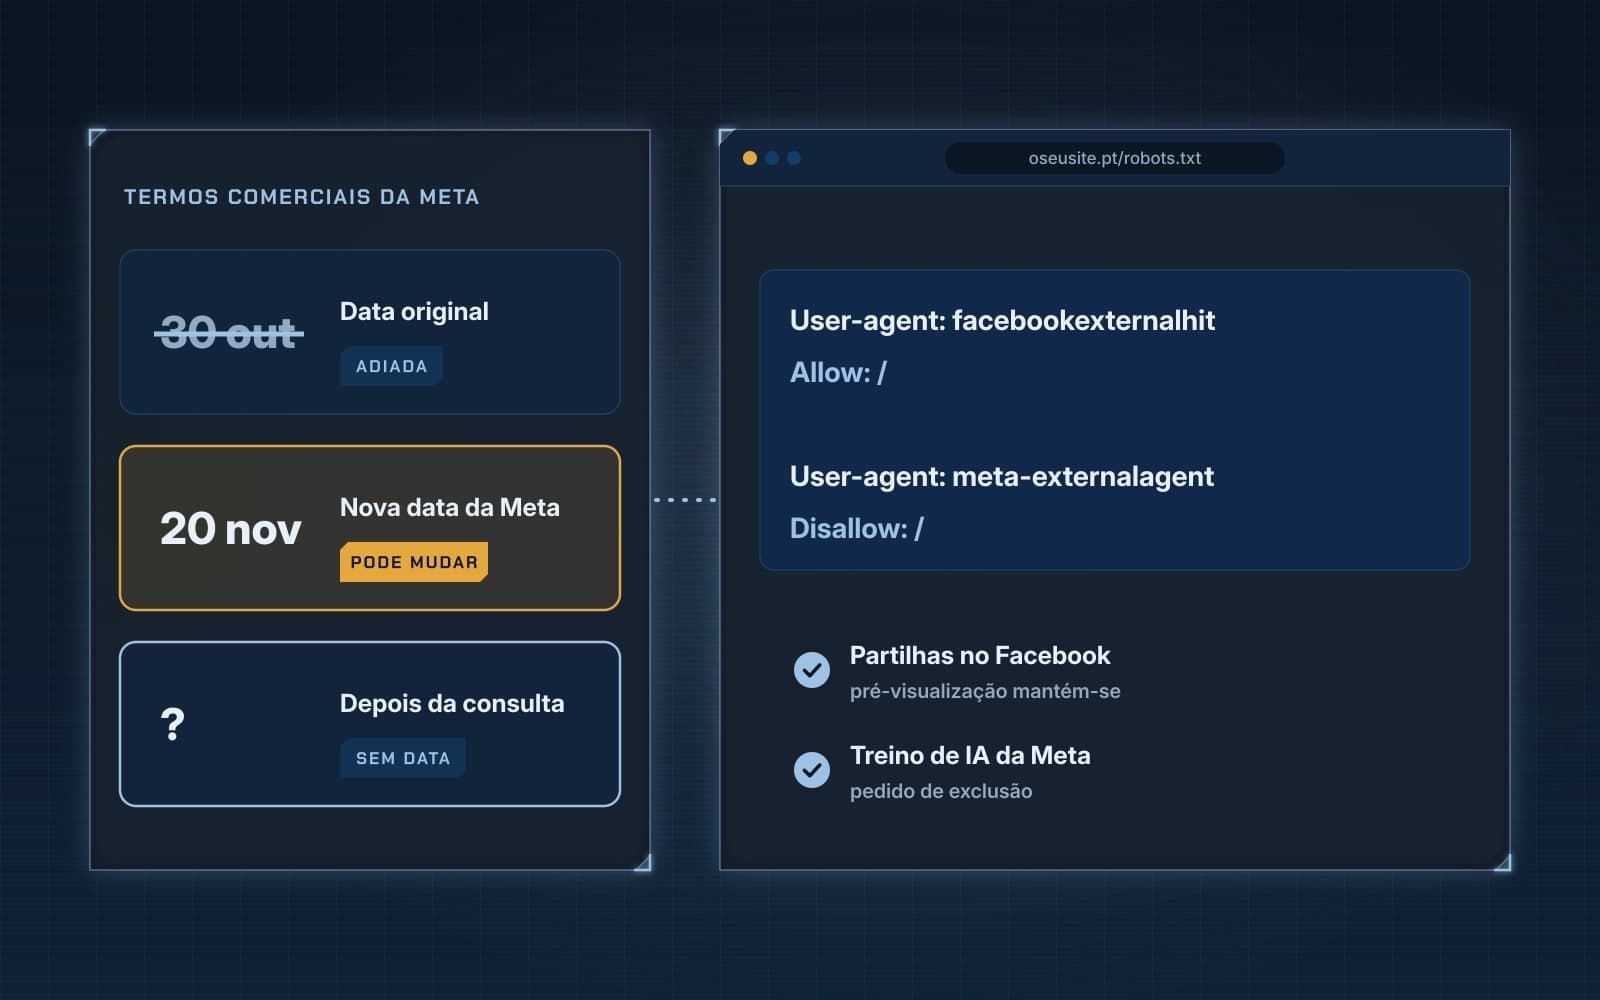
A 30 de outubro deviam entrar em vigor os novos Termos Comerciais da Meta, os que autorizam a empresa a visitar e recolher o conteúdo dos sites de quem usa o Facebook, o Instagram ou o WhatsApp para fins comerciais. Não entraram. Depois de uma onda de críticas de editores de imprensa, de queixas às autoridades da concorrência e de uma decisão de um tribunal norueguês, a Meta adiou primeiro a data para 20 de novembro e, a 28 de outubro, admitiu adiá-la outra vez, sem nova data.
Se a sua empresa gere uma página no Facebook, publica anúncios ou usa o Meta Business Suite, explicamos o que mudou desde o nosso primeiro artigo sobre estes termos, o que continua em aberto e o que vale a pena fazer no seu site entretanto.
O que a Meta anunciou
A 28 de outubro, o vice-presidente de comunicação da Meta, Andy Stone, publicou no X uma declaração citada pela Reuters e pelo Nieman Lab: "Ouvimos o feedback dos editores sobre a nossa proposta de atualização dos termos de publicidade e de negócio. [...] Não tencionamos fazer alterações às nossas políticas sem uma auscultação completa de associações e líderes do setor."
Na mesma declaração, a Meta acrescentou que essa consulta se pode prolongar para lá de 20 de novembro e que, nesse caso, adiará a aplicação dos termos atualizados. "Até lá, mantêm-se em vigor os nossos termos atuais", escreveu. A Reuters descreveu a decisão como um adiamento por tempo indeterminado. Em Portugal, o ECO noticiou o caso a 30 de outubro.
Na prática, a página oficial dos Termos Comerciais da Meta continua a indicar 20 de novembro de 2026 como data de entrada em vigor, mas a própria empresa já disse que essa data pode não se cumprir.
Como se chegou aqui
Recapitulando, com base nas notícias e nos comunicados citados:
- 15 de outubro: o Nieman Lab revela a primeira versão dos termos, que autorizava a Meta a usar o conteúdo dos sites associados às contas empresariais para "fornecer, desenvolver, melhorar, realizar investigação, treinar e manter a integridade" dos seus produtos.
- 16 e 17 de outubro: a Meta revê o texto. A palavra "treinar" desaparece e o uso passa a ser "fornecer, desenvolver, melhorar, investigar e manter produtos de publicidade e empresariais".
- 22 de outubro: a WAN-IFRA, associação mundial de editores de imprensa, pede à Meta que suspenda a cláusula, depois de associações europeias, britânicas e norte-americanas terem feito o mesmo.
- 23 de outubro: a Meta adia a entrada em vigor de 30 de outubro para 20 de novembro.
- 28 de outubro: a Meta admite novo adiamento e promete consultar o setor. No mesmo dia, um tribunal de Oslo proíbe a aplicação dos termos na Noruega até avaliar a sua legalidade.
O que continua igual no texto
O adiamento não mudou a redação. Segundo o Engadget, os termos propostos continuam a dar à Meta autorização para usar "software automatizado", como robôs, crawlers e scrapers, para aceder aos sites das empresas que usam os seus serviços, "para fornecer, desenvolver, melhorar, investigar e manter produtos de publicidade e empresariais".
O European Publishers Council, num comunicado atualizado a 29 de outubro, considera o adiamento bem-vindo, mas nota três pontos que continuam em aberto:
- retirar a palavra "treinar" não exclui expressamente o treino de IA, nem o uso do conteúdo para gerar respostas e resumos;
- a autorização inclui o acesso automatizado, a indexação, o armazenamento em cache, a análise e a recolha do conteúdo dos sites, bem como a criação de credenciais de teste;
- os termos não dão às empresas uma forma contratual de recusar estas permissões e continuar a usar os serviços da Meta.
Há ainda a questão do ficheiro robots.txt. A Meta tem dito que os donos dos sites podem continuar a usá-lo para indicar as suas preferências, mas, segundo o Nieman Lab, nenhuma versão dos termos inclui esse compromisso por escrito.
O que isto significa para uma PME em Portugal
Para já, nada muda no dia de hoje: os termos atuais continuam em vigor e não há uma nova data confirmada. Mas o tema não acabou. A Meta continua a indicar 20 de novembro na sua página, há queixas em análise nas autoridades da concorrência da União Europeia e do Reino Unido, segundo a Reuters, e a decisão norueguesa aplica-se apenas à Noruega.
A polémica tem sido sobretudo dos editores de notícias, mas a cláusula, tal como está escrita, abrange qualquer negócio que use a Meta para fins comerciais: gerir páginas e grupos, publicar anúncios, enviar mensagens de marketing ou usar o Meta Business Suite. Ou seja, também uma loja online, um restaurante ou uma clínica com página no Facebook.
O que pode fazer no seu site entretanto
Este período de espera é uma boa altura para decidir, com calma, que robôs quer deixar entrar no seu site. A documentação oficial da Meta lista os robôs que a empresa usa e para que serve cada um:
- FacebookExternalHit: gera a pré-visualização (título, descrição e imagem) quando alguém partilha uma página do seu site no Facebook, Instagram ou Messenger. Bloqueá-lo estraga essas partilhas.
- Meta-ExternalAds: serve para melhorar a publicidade e outros produtos e serviços de negócio.
- Meta-ExternalAgent: recolhe conteúdo para usos como o treino de modelos de IA de base ou a melhoria de produtos através da indexação direta.
- Meta-WebIndexer: melhora a pesquisa da Meta AI. Segundo a Meta, permiti-lo ajuda a citar e a ligar para o seu conteúdo nas respostas da Meta AI.
- Meta-ExternalFetcher: abre links a pedido de um utilizador e, segundo a Meta, pode ignorar o
robots.txt.
Se não quer que o conteúdo do seu site seja usado para treinar os modelos da Meta, pode acrescentar ao robots.txt uma regra como esta:
User-agent: meta-externalagent
Disallow: /
A Meta indica que as alterações podem demorar até 24 horas a ter efeito, porque os robôs guardam o ficheiro em cache. Antes de bloquear, pese o outro lado: deixar o Meta-WebIndexer entrar pode valer a pena se quer aparecer nas respostas da Meta AI, tal como acontece com o ChatGPT e o Modo IA do Google, que explicamos em como aparecer nas respostas da IA.
Lembre-se também do que o robots.txt não faz: é um pedido, não um cadeado. Áreas reservadas, preços para revendedores ou documentos internos devem estar protegidos por palavra-passe, e não apenas escondidos dos robôs. É a mesma lógica que defendemos no artigo sobre soberania digital e os dados da empresa.
O que ainda não se sabe
A Meta não disse quando vai terminar a consulta, quem vai participar nela nem se o texto final vai incluir o respeito pelo robots.txt ou uma forma de recusar a recolha. Também não é claro se o resultado será negociado apenas com os editores de imprensa ou se trará mudanças para todas as contas empresariais. Vamos acompanhar o tema e atualizar este artigo quando houver uma nova versão dos termos ou uma nova data.
Sabe que robôs entram no seu site?
Se não sabe o que diz hoje o robots.txt do seu site, ou se as partilhas no Facebook e no Instagram aparecem com a imagem e o título certos, comece pela auditoria gratuita da MarcaWeb. Em poucos minutos recebe uma nota sobre o SEO técnico, o desempenho e a segurança, e uma lista do que corrigir primeiro.