Meta recua nos termos que a deixavam treinar IA com os sites das empresas: o que muda a 30 de outubro
A Meta retirou dos novos termos a cláusula de treino de IA, mas a 30 de outubro continua a poder visitar o site da sua empresa. Veja como gerir o acesso.
Durante alguns dias, os novos Termos Comerciais da Meta pareceram dar à empresa uma autorização muito ampla: recolher o conteúdo dos sites de qualquer negócio com uma página no Facebook, um perfil profissional no Instagram ou um canal no WhatsApp, e usá-lo para treinar a sua inteligência artificial. Os termos entram em vigor a 30 de outubro de 2026. A 17 de outubro, depois de uma onda de críticas de jornalistas e juristas, a Meta retirou a frase mais polémica.
Se a sua empresa usa o Meta Business Suite, publica anúncios ou gere uma página no Facebook, explicamos o que mudou e o que pode fazer no seu site antes do dia 30.
O que dizem os novos Termos Comerciais
A Meta avisou os utilizadores da atualização no início de outubro, num artigo no seu blog e no Meta Business Suite. Segundo o Nieman Lab, que noticiou o caso a 15 de outubro, os novos termos abrangem as contas empresariais que gerem páginas e grupos, publicam anúncios, enviam mensagens de marketing ou usam o painel de negócio da Meta.
O texto autoriza a Meta, ou quem atue em seu nome, a usar programas automáticos (robôs, crawlers, scrapers) e a criar "credenciais de teste" para aceder, indexar, analisar e recolher o conteúdo dos domínios e páginas associados aos produtos ou serviços da empresa. Na versão publicada no início de outubro, acrescentava que a Meta podia usar esse conteúdo para "fornecer, desenvolver, melhorar, investigar, treinar e manter a integridade" dos seus produtos.
Não havia forma de recusar. Quem não concordasse com os termos devia, segundo o próprio texto, deixar de usar os produtos da Meta para fins comerciais.
O que era novo
A ideia de a Meta visitar os sites dos clientes não nasceu agora. De acordo com a análise do Search Engine Journal de 16 de outubro, os Termos de Anúncios Self-Serve, em vigor desde 22 de agosto de 2025, já davam à Meta o direito de rastrear os domínios de quem compra anúncios, incluindo para "investigação e treino". Os Termos Comerciais anteriores, de 6 de março de 2024, não tinham nenhuma cláusula deste tipo.
A novidade era o alcance. A autorização deixava de depender da compra de anúncios e passava a valer para qualquer uso comercial da Meta. Incluindo uma pequena empresa que só mantém uma página no Facebook.
Porque é que a cláusula gerou polémica
Três juristas consultados pelo Nieman Lab consideraram que o texto podia servir para a Meta argumentar que tinha autorização para recolher conteúdo de sites, incluindo sites de notícias, e treinar com ele os seus modelos de IA. James Grimmelmann, professor de direito digital na Universidade de Cornell, notou ainda que as "credenciais de teste" permitiriam, tecnicamente, criar um utilizador fictício para passar áreas de registo.
Outra preocupação era o ficheiro robots.txt, a forma habitual de um site dizer aos robôs onde podem entrar. A Meta garantiu que continuava a respeitá-lo. Mas, segundo o Search Engine Journal, nenhum dos novos termos o mencionava, o que deixava aberta a leitura de que um contrato aceite pela empresa se sobrepunha a esse ficheiro. O European Publishers Council anunciou que ia escrever à Comissão Europeia sobre o assunto.
O recuo de 17 de outubro
A 17 de outubro, o The Verge confirmou que a frase sobre usar "qualquer conteúdo" desses domínios para "treinar" os produtos da Meta deixou de aparecer na página dos Termos Comerciais. O TechCrunch confirmou a alteração no mesmo dia.
Em declarações ao The Verge, o porta-voz da Meta Daniel Roberts explicou: "Ouvimos as críticas e queremos esclarecer: os termos sobre rastreamento que consolidámos aplicavam-se apenas aos nossos produtos de anúncios e de negócio, e clarificámos isso nos próprios termos. Isto não muda a forma como a Meta usa os seus robôs. Como sempre, os donos dos conteúdos podem usar o robots.txt para indicar as suas preferências."
Ou seja, a data de 30 de outubro mantém-se, e a autorização para a Meta visitar os sites associados às contas empresariais continua a existir. Segundo a empresa, essa autorização serve os anúncios e os produtos de negócio, por exemplo para obter informação correta sobre os produtos que uma loja vende. A referência explícita ao treino foi retirada.
O que isto significa para uma pequena empresa
Para a maioria das PME, a visita dos robôs da Meta é normal e até útil. É ela que gera a pré-visualização com imagem e título quando alguém partilha uma página do seu site, e que mantém atualizado o catálogo de uma loja ligada ao Facebook e ao Instagram.
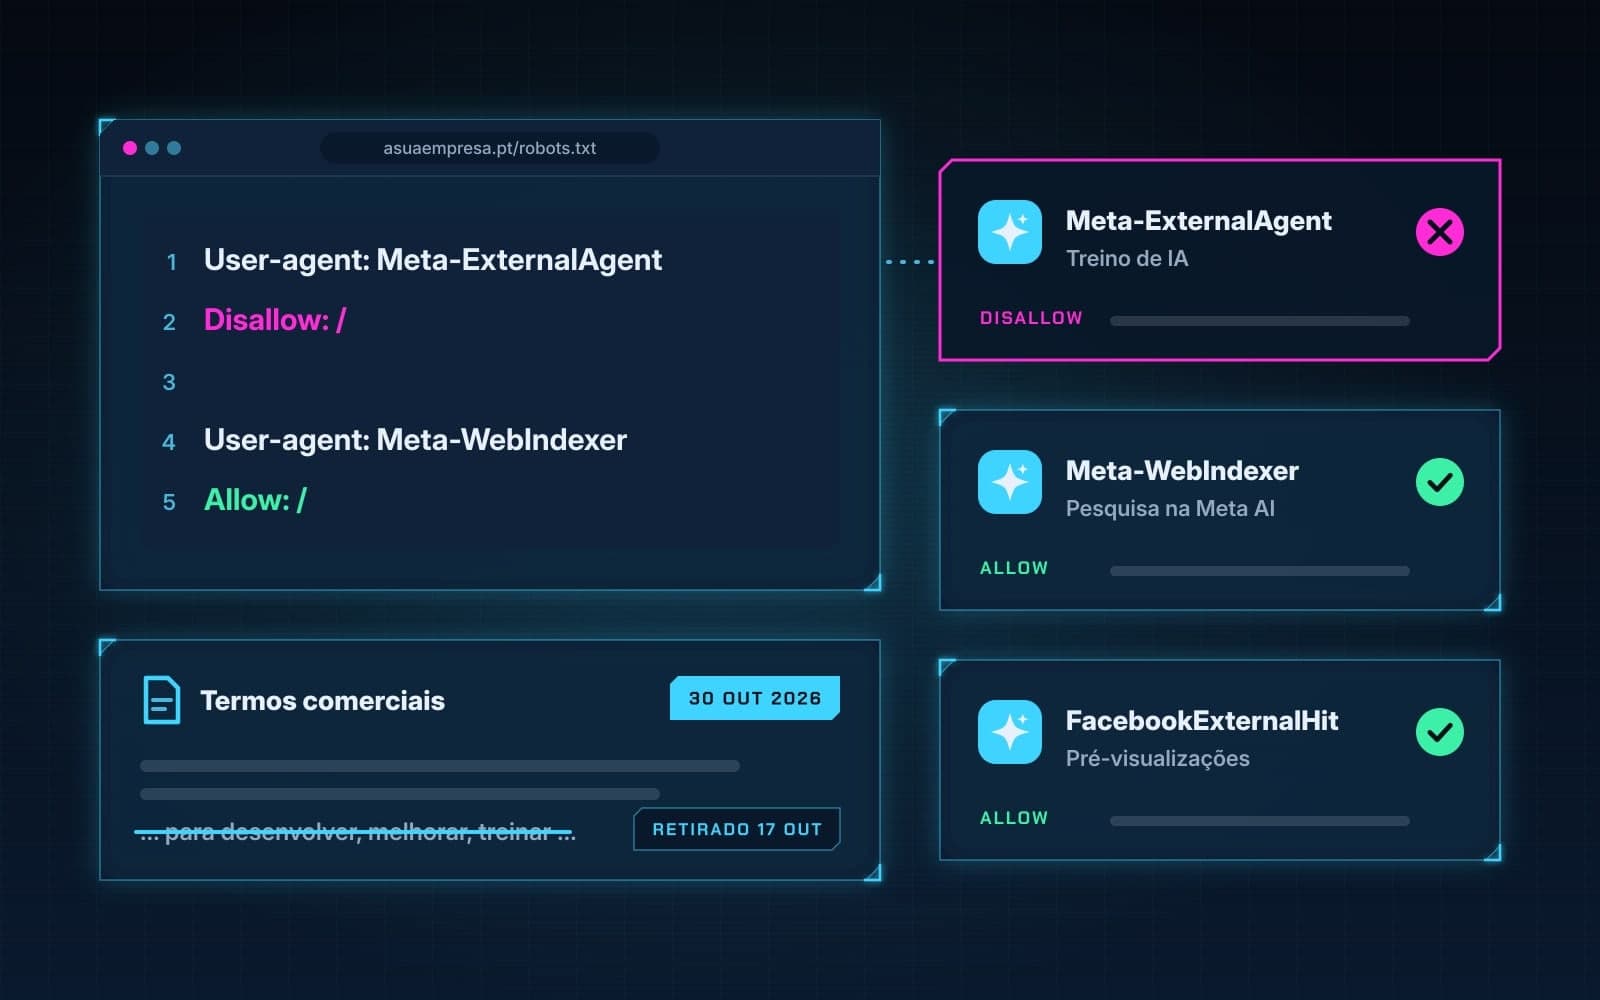
A questão do treino de IA é diferente, e aí a decisão continua nas suas mãos. Segundo a documentação da Meta, resumida pelo Search Engine Journal, a empresa usa robôs distintos para fins distintos:
- Meta-ExternalAgent: recolhe conteúdo para usos como o treino de modelos de IA ou a melhoria de produtos através da indexação direta.
- Meta-WebIndexer: melhora os resultados de pesquisa da Meta AI. A Meta diz que permitir este robô a ajuda a citar e a ligar para o seu conteúdo nas respostas.
- Meta-ExternalFetcher: vai buscar uma página a pedido de um utilizador e pode ignorar o robots.txt.
- FacebookExternalHit: cria as pré-visualizações de ligações e pode ignorar o robots.txt em verificações de segurança e integridade.
Esta separação permite, por exemplo, bloquear o robô de treino e manter o de pesquisa, para continuar a poder aparecer, com ligação, nas respostas da Meta AI. É a mesma lógica que explicámos em Como aparecer nas respostas do ChatGPT e do Modo IA.
Como controlar o acesso no seu site
O ficheiro robots.txt fica na raiz do site (por exemplo, asuaempresa.pt/robots.txt). Para impedir o robô de treino da Meta e deixar passar o de pesquisa, bastam estas linhas:
User-agent: Meta-ExternalAgent
Disallow: /

User-agent: Meta-WebIndexer
Allow: /
Não bloqueie o FacebookExternalHit se quer que as partilhas do seu site no Facebook, no Instagram e no WhatsApp apareçam com imagem e título.
Lembre-se de que o robots.txt é um pedido, não uma fechadura. Tudo o que for verdadeiramente privado, como áreas de clientes, propostas ou documentos internos, deve estar protegido por autenticação real e não apenas escondido.
Lista para fazer antes de 30 de outubro
- Leia o aviso no Meta Business Suite e guarde uma captura com a data. Os termos já mudaram uma vez desde o anúncio.
- Abra o robots.txt do seu site e veja o que diz sobre os robôs da Meta. Muitos sites não têm nenhuma regra.
- Decida robô a robô: treino de IA, pesquisa da Meta AI, pré-visualizações. Não tem de ser tudo ou nada.
- Proteja o que é privado com palavra-passe ou sessão, e não com páginas escondidas ou endereços difíceis de adivinhar.
- Reveja onde estão os seus dados. Se o tema o preocupa, leia também Soberania digital: onde estão os dados da sua empresa.
Em resumo
Os novos Termos Comerciais da Meta entram em vigor a 30 de outubro de 2026 e autorizam a empresa a visitar com robôs os sites associados às contas empresariais. Depois das críticas, a Meta retirou a 17 de outubro a frase que lhe permitia usar esse conteúdo para "treinar" os seus produtos, e afirma que o robots.txt continua a ser respeitado. Para uma PME, o passo prático é rever o robots.txt e decidir que robôs aceita, sobretudo o Meta-ExternalAgent, usado para treino de IA.
Quer saber o que o seu site está a mostrar aos robôs?
A nossa auditoria gratuita analisa a segurança e o desempenho do seu site e mostra o que corrigir. Se preferir que tratemos do robots.txt e das regras para robôs de IA, escreva para info@marcaweb.pt ou ligue para o +351 920 260 897.